Jalapeño entra en despliegue: el chip de inferencia de OpenAI se monta sobre CPUs AMD EPYC Turin
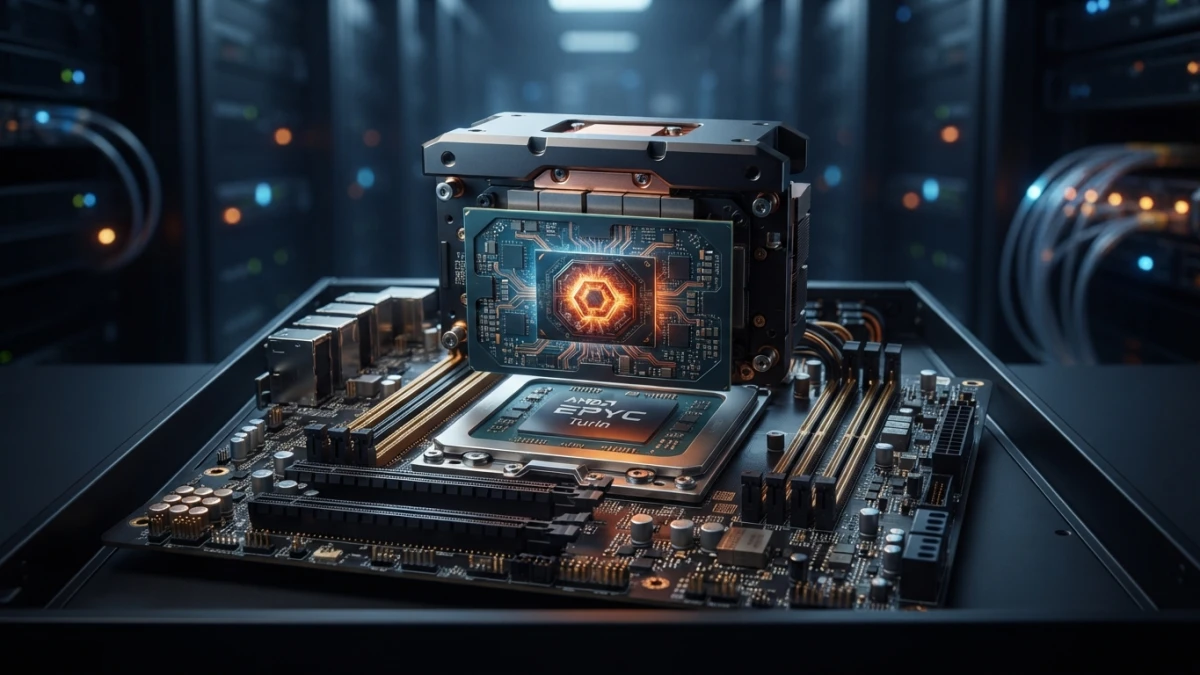
OpenAI ya despliega Jalapeño, su chip de inferencia, junto a CPUs AMD EPYC Turin con unos 1,5 TB de memoria por host. La noticia del 2 de octubre de 2026 no es el chip, sino cómo se monta el sistema que lo rodea.
Qué se confirmó el 2 de octubre
Jalapeño entra en despliegue interno y la noticia está en el host
El viernes 2 de octubre, Tom's Hardware publicó que los ASIC Jalapeño de OpenAI ya están desplegados acompañados de procesadores AMD EPYC "Turin" que ejercen de host. El despliegue es interno: no hay ninguna oferta pública asociada, ni precio anunciado, ni cifra de unidades desplegadas. SemiAnalysis describió la configuración a escala de rack, y la elección de la CPU se confirmó en una entrevista con Richard Ho, vicepresidente y responsable de hardware de OpenAI.
Conviene separar tres capas que los titulares mezclan: lo que reporta un analista, lo que dice la empresa en una entrevista y lo que interpreta la prensa. El titular fácil es "OpenAI deja de depender de Nvidia" y el titular perezoso es "OpenAI tiene su propio chip". Los dos están mal.
AMD EPYC Turin en vez de Nvidia Vera: las tres razones que dio Richard Ho
La pregunta obvia es por qué una compañía con una relación profunda con Nvidia monta su primer chip propio sobre CPUs de AMD. La respuesta de Ho es menos épica que el titular y bastante más útil: madurez de la plataforma, experiencia previa de los socios con Turin y voluntad de moverse rápido sin asumir riesgo de diseño innecesario.
Lee también
Sobre la CPU Vera de Nvidia, Ho la situó "un poco por detrás" en ese nivel de madurez como opción independiente. Es una frase sobre madurez de plataforma y contexto de host, no un veredicto sobre la GPU ni una ruptura con Nvidia: el mismo despliegue convive con los contratos de cómputo que OpenAI mantiene con el fabricante.
Cómo se ve el sistema por dentro
Según el análisis de SemiAnalysis, cada host lleva dos CPU de la clase Turin, alrededor de 1,5 TB de DRAM y red frontal de 400G. Cada bandeja de aceleradores agrupa varios Jalapeño en un chasis y el armario completo suma un número alto de XPU. Los detalles exactos de bandeja y armario hay que atribuirlos a su fuente: son la descripción del analista, no un comunicado de OpenAI.
En una frase: dentro de un rack de inferencia hay cuatro piezas que deciden el coste, el acelerador, la CPU host, la memoria y la red. El chip es solo la primera.
Qué es Jalapeño y qué no es
Un ASIC de inferencia, no de entrenamiento
Jalapeño es un ASIC, un chip diseñado para una tarea concreta. En este caso, servir modelos ya entrenados con la mayor eficiencia posible. No los entrena. Renunciar a la flexibilidad del entrenamiento es precisamente lo que permite ganar en trabajo por vatio y en latencia, las dos métricas que se pagan cuando un modelo ya está en producción.
Broadcom, TSMC N3P y un tape-out de 16 meses
El chip se presentó públicamente en Hot Chips 2026, el 25 de agosto, no el 2 de octubre. Está diseñado por OpenAI y fabricado con Broadcom sobre el proceso N3P de TSMC, con un tape-out de 16 meses. Un detalle que sorprende a mucha gente: no está afinado para los modelos propios de OpenAI, sino pensado para servir modelos abiertos. Es parte del plan, no una limitación accidental.
Las cifras que circulan vienen de un tercero
Los datos de rendimiento más repetidos son 13,4 PFLOPs en MXFP4 a 700 W y HBM4 a 15,4 TB/s, con kernels de atención y de MoE entre 1,5 y 1,8 veces más rápidos que implementaciones escritas a mano. Todos vienen de SemiAnalysis e InferenceX, medidos sobre muestras de ingeniería y modelos abiertos, y el propio análisis reconoce que la comparación con Blackwell es incompleta. Hay que leerlos siempre como medición de terceros, nunca como dato oficial de OpenAI.
En el mismo terreno está la eficiencia: hasta 1,9 veces más trabajo por vatio frente a GB200 y GB300. Es una medición sobre modelos abiertos, no una promesa de producción.
Por qué el host importa más de lo que parece
Qué hace la CPU en un sistema de inferencia
La CPU host no genera tokens. Prepara los lotes de entrada, tokeniza, mueve datos entre la memoria y los aceleradores, ejecuta el código que no es una operación matricial y atiende la red y la orquestación. Si el host se queda corto, los aceleradores esperan; si se pasa de potencia, se paga energía por trabajo que no aporta tokens.
Memoria del host y espera del acelerador
Los 1,5 TB por host no son un adorno. Los modelos, las cachés de contexto y los datos de trabajo viven en memoria, y cuanto más cerca estén del acelerador, menos milisegundos se pierden moviéndolos. Es la misma lógica de cuello de botella que ya contamos al hablar de la escasez de memoria hasta 2028.
Elegir host no es elegir GPU
Montar Jalapeño sobre Turin no significa que OpenAI abandone Nvidia. La compañía sigue comprando y contratando cómputo del fabricante, como muestra el acuerdo de 180.000 millones contratados con Anthropic. Lo que cambió es qué CPU acompaña a un acelerador concreto en un despliegue concreto.
Qué cambia para quien sirve modelos o paga la factura
Coste por token frente a coste por vatio
Al elegir un proveedor de inferencia conviene mirar varias cosas a la vez:
- El coste real por token, no solo el precio de lista del modelo.
- El coste por vatio y el consumo por megavatio, que deciden la factura a escala.
- La latencia y la capacidad de sostener contexto largo sin degradarse.
- Qué fracción del pico teórico se convierte en tokens reales.
La capa de software decide cuánto del pico se aprovecha
OpenAI escribe sus propios kernels y su propio lenguaje, Gluon, en vez de depender solo de los de Nvidia. No es un chip nuevo ni un titular: es la parte que traduce el pico teórico del silicio en trabajo real. Un acelerador rápido con software flojo rinde menos que uno modesto con kernels afinados, y esa lección sirve para cualquier stack de inferencia.
Un mercado con más de un silicio
El mapa de chips de IA ya no tiene un solo protagonista: están Nvidia, AMD y Broadcom, y a eso se suman los chips propios de los laboratorios, desde los MTIA de Meta hasta el Ascend 960DT de Huawei o el Zhenwu V900 de Alibaba. Para quien programa, la decisión se parte en dos: qué modelo usas y sobre qué infraestructura corre. Son elecciones distintas, con costes distintos.
La capa de software que acompaña a este hardware también cambia rápido, como se vio en el DevDay 2026 de OpenAI.
Lo que todavía no se sabe
No hay precio público, ni unidades desplegadas, ni ahorros confirmados. Tampoco está claro cuánto del rendimiento medido se sostiene en producción a gran escala con modelos de frontera. Y las mediciones de agosto no deben leerse como resultados de octubre: son momentos distintos y conviene no mezclarlos.
Conclusión
Jalapeño es un paso real, pero la parte más instructiva de la noticia es la plomería. El coste de servir un modelo no lo decide una pieza: lo decide el conjunto de acelerador, host, memoria, red y kernels. Comparar chips sueltos se parece a comparar coches por la potencia del motor sin mirar el peso ni el consumo. Si te interesa cómo se paga la IA por dentro, sigue leyendo el blog: aquí desmontamos la infraestructura pieza por pieza.