Tu consulta tarda cuatro segundos: cómo encontrarla y arreglarla en MySQL 8.4
La página tarda seis segundos y todo el problema cabe en una línea de SQL. Antes de tocar nada hay que medir: este es el recorrido que va del slow query log al EXPLAIN, de ahí al índice que falta y de vuelta a la medición para comprobar que la mejora es real.
Paso 1: encontrar la consulta culpable sin reiniciar el servidor
El slow query log se puede activar en caliente con variables de sistema, sin reiniciar MySQL. Lo que necesitas controlar son tres variables y una decisión sobre dónde escribir.
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 0.5;
SET GLOBAL log_output = 'TABLE';
Con log_output='TABLE' las entradas quedan en la tabla mysql.slow_log, que se consulta con SQL y se filtra como cualquier otra tabla; con 'FILE' van a un archivo del servidor. La tabla es más cómoda cuando no tienes acceso al sistema de archivos de la base de datos. long_query_time acepta valores con decimales, así que empezar en medio segundo suele ser buen punto de partida.
Qué leer en cada entrada
De cada registro importan cuatro columnas: query_time (cuánto tardó), lock_time (cuánto esperó por bloqueos), rows_examined (filas que el motor tuvo que leer) y rows_sent (filas que devolvió). La comparación entre las dos últimas es la señal más útil y la que casi nadie mira: una consulta que examina cuatro millones de filas para devolver veinte está haciendo un trabajo enorme para nada.
Lee también
SELECT query_time, rows_examined, rows_sent, LEFT(sql_text, 120) AS sql
FROM mysql.slow_log
ORDER BY rows_examined DESC
LIMIT 10;
log_queries_not_using_indexes: útil con cuidado
Esta variable registra toda consulta que no use índice, aunque sea rapidísima. En una tabla de cien filas eso es normal y no es un problema, así que activarla sin más llena el log de ruido y esconde lo que sí duele. Si la usas, acompáñala de min_examined_row_limit para que solo queden las consultas que además leen muchas filas.
La alternativa rápida: el esquema sys
MySQL trae el esquema sys, con vistas que ya vienen agregadas: las de sentencias con escaneo completo de tabla y las de índices sin uso. Sirven para priorizar antes de leer un solo plan: primero se ve qué consulta consume más tiempo total, y después se investiga esa.
Paso 2: leer el plan con EXPLAIN sin perderse
EXPLAIN funciona sobre SELECT, DELETE, INSERT, REPLACE y UPDATE y responde a una pregunta simple: qué camino eligió el optimizador. Cinco columnas bastan para casi todo.
type: cómo accede a la tabla.ALLes un escaneo completo;range,refyconstson mejores en ese orden.key: el índice que realmente se usó (distinto depossible_keys, que solo lista candidatos).rows: filas que el optimizador estima que leerá. Es una estimación, no un dato.filtered: porcentaje estimado de filas que sobreviven al filtro.Extra: aquí aparecen los avisos que importan.
Las señales rojas se leen así: type: ALL con un número alto de rows significa escaneo completo de una tabla grande; Using filesort indica que el motor ordenó el resultado por su cuenta, sin ayuda del índice; Using temporary implica una tabla temporal intermedia, típica de ciertos GROUP BY y DISTINCT; y Using index es la buena noticia: el índice contiene todo lo que la consulta necesita y no hace falta tocar la tabla.
FORMAT=TREE y FORMAT=JSON
El formato clásico es una tabla, útil para una consulta con una o dos tablas. Cuando hay varias uniones o subconsultas, EXPLAIN FORMAT=TREE muestra el plan como un árbol, y FORMAT=JSON da además los detalles que el formato clásico esconde, como los costes por bloque. Empieza por el clásico y cambia solo cuando la consulta se complique.
Paso 3: medir lo que pasó de verdad con EXPLAIN ANALYZE
EXPLAIN ANALYZE está disponible desde MySQL 8.0.18 y hace algo distinto: ejecuta la consulta y muestra, por iterador, el tiempo real y las filas reales. Donde el EXPLAIN clásico dice "creo que leeré 12 filas", este dice cuántas leyó y cuánto tardó cada paso.
Aviso que no se puede omitir: como ejecuta la consulta, un EXPLAIN ANALYZE sobre un UPDATE o un DELETE pesado hace el trabajo de verdad. En producción, envuélvelo en una transacción que reviertas o resérvalo para las consultas de solo lectura.
Los iteradores se leen en orden
La salida se lee de arriba abajo y de dentro hacia fuera: los nodos anidados son los pasos que alimentan al padre. Los campos actual time (primer y último registro del iterador), rows y loops permiten ver dónde se va el tiempo: un bucle que se repite mil veces con un tiempo bajo por iteración puede pesar más que un único escaneo grande.
Cuando el optimizador se equivoca
Comparar las filas estimadas del plan con las reales es el diagnóstico más honesto que existe. Si la estimación dice 10 y el plan real dice 400.000, el problema puede no ser un índice que falte sino estadísticas desactualizadas. ANALYZE TABLE recalcula la distribución de las claves, y los histogramas (que se crean con ANALYZE TABLE ... UPDATE HISTOGRAM) ayudan cuando los datos están muy sesgados y el optimizador no acierta. En tablas grandes esta operación tiene coste: elige la ventana horaria.
Paso 4: índices, y las cuatro razones por las que no se usan
Un índice no es gratis: acelera las lecturas del patrón para el que sirve y encarece cada escritura, además de ocupar espacio. Por eso se añade después de medir, no antes.
Índice compuesto: igualdad primero, rango después
En un índice sobre (a, b, c) rige la regla del prefijo izquierdo: el optimizador puede usarlo para filtrar por a, por a, b o por a, b, c, pero no por b sola. El orden de las columnas define para qué consultas sirve el índice, y por eso conviene poner primero las columnas que se comparan por igualdad y dejar para el final las que se usan en rangos u ordenaciones.
Trampa 1: envolver la columna en una función (o en un CAST)
Una consulta como WHERE DATE(created_at) = '2026-09-01' aplica una función a la columna y el índice sobre created_at queda inservible. La solución es escribir la condición como rango: WHERE created_at >= '2026-09-01' AND created_at < '2026-09-02'. Lo mismo ocurre al aplicar CAST sobre la columna comparada.
Trampa 2: LIKE '%texto%' no puede usar un índice
Un comodín al inicio impide usar el orden del índice, porque no hay forma de recorrerlo desde un punto conocido. Para búsquedas de texto completo, la herramienta es FULLTEXT, no un índice B-tree disfrazado. Un LIKE 'texto%' sí puede aprovechar el índice: ahí el prefijo está definido.
Trampa 3: tipos y collations distintos fuerzan conversiones
Comparar una columna VARCHAR con un número, o columnas con collations distintas en una unión, obliga al motor a convertir valores y puede dejar el índice fuera de juego. Revisar los tipos declarados es aburrido y suele ser la causa real de un type: ALL inesperado.
Trampa 4: ORDER BY y GROUP BY que no siguen el índice
Cuando el orden pedido coincide con el orden del índice y las condiciones de filtrado permiten seguirlo, MySQL se ahorra la ordenación. Cuando no coincide, aparece Using filesort y el motor ordena en memoria o en disco. Si detectas esa señal en una consulta frecuente, el arreglo puede ser un índice cuyas columnas de orden sean las últimas del índice compuesto.
Índice cubriente e índices invisibles
Un índice que contiene todas las columnas que la consulta lee y filtra permite responder sin tocar la tabla (el Using index del que hablábamos). En la práctica implica evitar SELECT * y seleccionar solo lo necesario. Y para probar el efecto de quitar un índice sin borrarlo existe el índice invisible: ALTER TABLE ... ALTER INDEX ... INVISIBLE lo deja declarado pero el optimizador lo ignora, así que puedes medir en producción antes de decidir un DROP INDEX.
Patrones que se comen el rendimiento (y su arreglo)
Paginación profunda: por qué OFFSET 100000 es lento
LIMIT 20 OFFSET 100000 no salta a la fila 100.000: lee y descarta las anteriores. La alternativa es la paginación por clave, filtrando por el último valor visto de una columna indexada: WHERE id > :ultimo ORDER BY id LIMIT 20. Es más rápido y además no se descoloca si entra contenido nuevo.
SELECT *, subconsultas repetidas y N+1
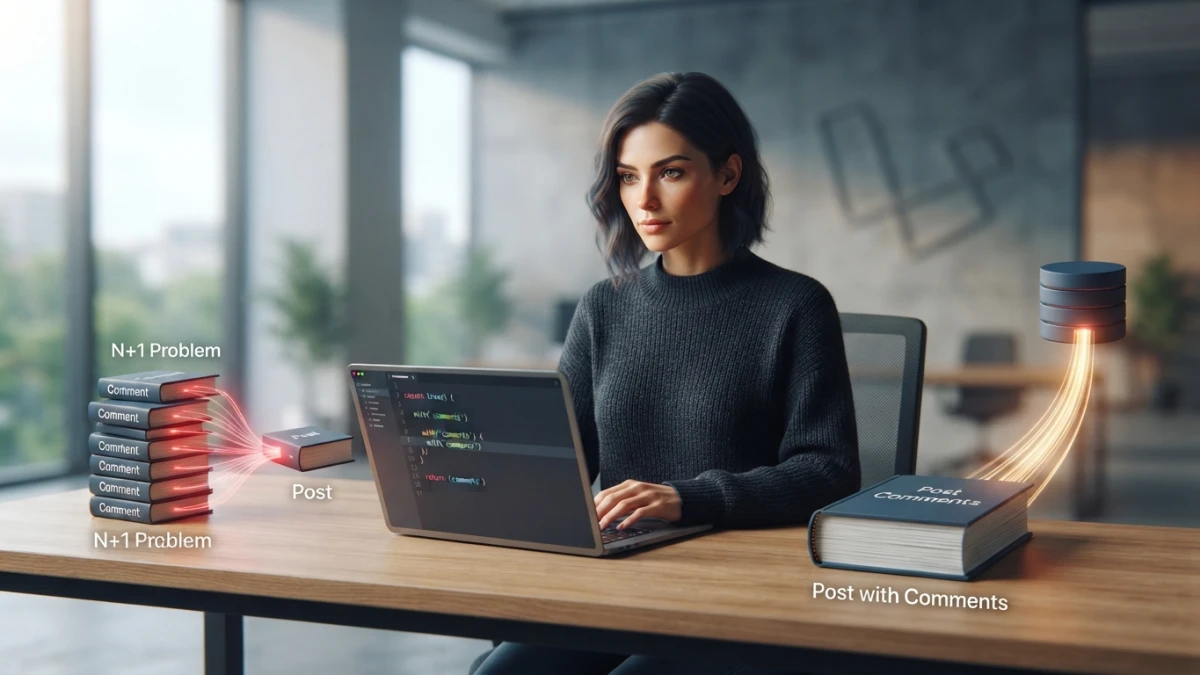
Pedir todas las columnas impide el índice cubriente y trae más datos de los que se usan. Las subconsultas y los agregados que se repiten en la misma petición suelen resolverse con una consulta agregada y un JOIN. Y el clásico N+1 del ORM se arregla en el código (cargando la relación de una vez), no con un índice: son problemas distintos y conviene no confundirlos.
Del motor a Laravel: sacar el SQL real y medirlo
Si la consulta lenta la genera Eloquent, el primer paso es verla tal cual y con los valores ya enlazados, para pegarla en el cliente de MySQL y correr el EXPLAIN sobre ella.
DB::listen(function ($query) {
    logger()->debug($query->toRawSql(), ['ms' => $query->time]);
});
toRawSql() devuelve el SQL con los valores incorporados, que es justo lo que necesitas para reproducirlo. Y en las migraciones, al declarar un índice compuesto el orden de las columnas es una decisión de rendimiento, no un detalle de estilo: escríbelo pensando en las consultas que vas a hacer. Recuerda que un índice no arregla consultas redundantes: si la aplicación pide tres veces lo mismo en una petición, el problema está en la lógica.
Cómo verificar que mejoró (y que no te engañaste)
La forma honesta de comprobar una optimización no es el cronómetro, es rows_examined antes y después. Un tiempo que baja sin que bajen las filas examinadas puede ser solo caché caliente. Y ojo con dónde mides: en tu equipo los datos son pocos, el buffer pool está caliente y todo parece volar; en producción el plan puede ser otro porque cambia el volumen, la distribución de los valores y las estadísticas. Cambia una cosa a la vez, anota el antes y el después, y deja pasar el tráfico real antes de dar por cerrado un ajuste.
Conclusión
El orden importa más que las herramientas: medir, leer el plan, medir de nuevo con datos reales y solo entonces tocar los índices. Si te quedas con una idea, que sea la comparación de filas examinadas, porque es la que separa una mejora real de una percepción. En el blog tienes la guía para eliminar el problema N+1 en Laravel, el query builder avanzado con subconsultas y expresiones SQL y la guía de Octane para acelerar tu aplicación: tres piezas que se combinan bien con este procedimiento.